
Blog
IA na análise documental clínica: por que desidentificar antes
- IA
- Anonimização
- LGPD
- Privacidade
- CFM 2.454
“IA na análise documental reduz erros” virou frase de catálogo. É verdade: um modelo lê um lote de PDFs, classifica, extrai campos e devolve uma planilha em minutos, com menos erro de digitação do que uma pessoa cansada no fim do expediente. Fornecedores de gestão de documentos já escrevem artigos inteiros sobre isso.
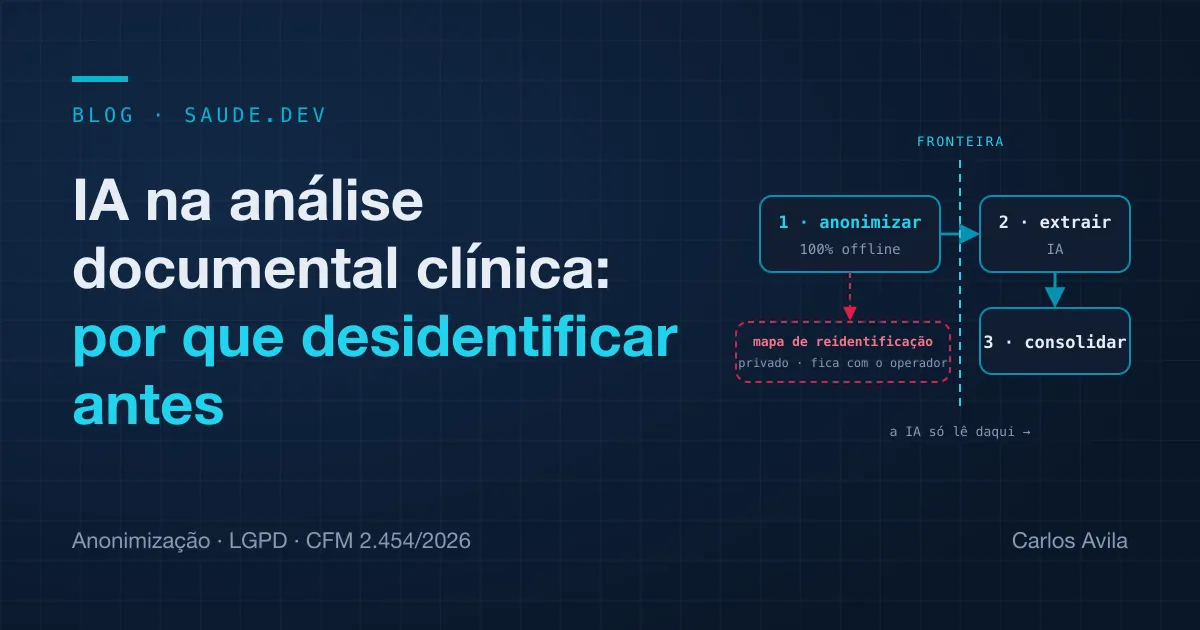
Em documento clínico, porém, a pergunta não é quantos erros a IA evita. É o que a IA vê. Este post defende uma ordem de operações simples — anonimizar, extrair, consolidar — em que a primeira etapa roda localmente, sem rede, antes de qualquer modelo tocar o texto. E mostra como isso funcionou num caso real.
O que a IA faz num documento — e o que ela não precisa ver
Análise documental com IA costuma ser três tarefas encadeadas: reconhecer o texto (OCR, quando o documento é imagem), classificar o documento (anamnese, laudo, encaminhamento, receita) e extrair campos estruturados (queixa principal, hipótese diagnóstica, medicações, encaminhamentos).
Nenhuma dessas tarefas precisa do nome do paciente. Nem do CPF, do cartão SUS, do nome da mãe, do endereço ou do telefone. O valor da extração está no conteúdo clínico; o identificador só serve para ligar o resultado de volta à pessoa — e essa ligação pode ser feita por quem já tem acesso ao original, depois, sem o modelo.
Separar as duas coisas no papel, antes de escrever uma linha de código, é a decisão que define o resto do projeto: quais campos são úteis (entram no prompt) e quais são identificadores (nunca entram).
Documento clínico não é nota fiscal
Uma nota fiscal tem CNPJ, valores e itens. Uma anamnese tem histórico psiquiátrico, uso de substâncias, situação familiar, violência sofrida, diagnósticos. A LGPD chama isso de dado pessoal sensível (art. 5º, II) e reserva a ele um regime próprio de tratamento (art. 11). Colar esse texto num chatbot de consumo é compartilhar dado sensível com um operador que você não contratou, para uma finalidade que o paciente não conhece.
A Resolução CFM nº 2.454/2026 fecha o outro lado. O médico deve assegurar que o compartilhamento de dados pessoais dos pacientes, “sobretudo os sensíveis”, com sistemas de IA ocorra “apenas quando estritamente necessário” (art. 6º, §1º), e está proibido de usar sistemas que não garantam padrões mínimos de segurança compatíveis com dado sensível (art. 6º, §3º). O art. 16 manda tratar os dados usados em IA observando rigorosamente a proteção de dados pessoais. E o Anexo I lista privacy by design entre os princípios, “inclusive mediante anonimização e criptografia de dados sensíveis, de modo a minimizar a exposição de informações identificáveis de pacientes” (XV).
Ou seja: a norma não pede que o médico deixe de usar IA em documentos. Pede que o dado identificável não chegue ao modelo sem necessidade — e “sem necessidade” é quase sempre o caso na extração.
Anonimizar, extrair, consolidar
A ordem é a arquitetura. Se a IA entra antes da desidentificação, nenhum contrato de processamento de dados conserta o que já foi enviado. Cada etapa tem uma regra:
- Anonimizar roda offline. Um script lê os originais, remove identificadores do conteúdo e dos nomes de arquivo, e grava um corpus em texto puro. Nenhuma chamada de rede.
- Entre a etapa 1 e a 2, uma pessoa revisa uma amostra do corpus. Detector nenhum pega tudo; a revisão é parte do pipeline, não um extra.
- Extrair lê apenas o corpus desidentificado. O modelo recebe um documento por vez, um esquema fixo de campos, e devolve um JSON.
- Consolidar normaliza os JSONs numa base. Essa etapa nunca reencontra o original: trabalha com os identificadores anônimos que a etapa 1 criou.
- O mapa de reidentificação — a tabela que liga o nome anônimo ao arquivo original — fica com o operador, fora do diretório que a IA lê. Se um dia for preciso voltar ao caso, quem volta é a pessoa autorizada, com o mapa em mãos.
Um caso real: anamneses que o modelo nunca leu
O caso que motivou este post: um lote de anamneses em .docx de adolescentes atendidos num serviço de saúde do sistema socioeducativo, que precisava virar uma base estruturada no mesmo formato de anos anteriores. É o dado mais delicado que existe — menor de idade, contexto de privação de liberdade, saúde mental — e por isso a escolha da ordem não foi opcional.
O script da etapa 1 faz o trabalho pesado sem tocar a rede:
- Apaga os campos de cabeçalho por rótulo: nome, filiação, endereço, telefone, CPF, RG, cartão SUS, matrícula, número de prontuário e de processo.
- Passa expressões regulares no texto livre para CPF, telefone, e-mail, cartão SUS, datas de nascimento, número de processo e links do sistema de protocolo — inclusive quando o link aparece sem o prefixo
http. - Remove a assinatura do profissional e detecta nomes próprios soltos após o título do relatório, que é onde a pessoa costuma vir sem rótulo nenhum.
- Preserva a data do atendimento, porque ela é o campo clínico, não o identificador.
- Renomeia cada arquivo para
at_AAAAMM_NNN, para que nem o nome do arquivo carregue o nome do adolescente. - Grava o mapa de reidentificação num arquivo marcado
_PRIVADO, ao lado da pasta de saída, não dentro dela.
A etapa 2 é um modelo de linguagem operando com um prompt de extração e um esquema fechado — e o CLAUDE.md do projeto, o arquivo de instruções que o agente lê antes de qualquer coisa, proíbe explicitamente que ele abra os originais ou o mapa. A única pasta permitida é a de texto anonimizado. A etapa 3 consolida em planilha e aplica vocabulários controlados.
O modelo nunca viu um nome. Não porque confiamos no modelo, mas porque o nome nunca chegou lá.
Funcionou? A extração funcionou como qualquer extração com IA funciona: bem na maior parte, com revisão nos casos de borda. O que mudou foi o custo do erro. Um campo extraído errado corrige-se na planilha. Uma anamnese identificada enviada para fora não se corrige.
Anonimizado ou pseudonimizado? A diferença que o mapa faz
Aqui é preciso ser honesto com os termos. Enquanto o mapa de reidentificação existe, o corpus está pseudonimizado, não anonimizado. A LGPD define pseudonimização como o tratamento pelo qual o dado perde a associação com a pessoa “senão pelo uso de informação adicional mantida separadamente pelo controlador em ambiente controlado e seguro” (art. 13, §4º). Anonimização, para a lei, é o processo pelo qual o dado perde a possibilidade de associação por “meios técnicos razoáveis e disponíveis” (art. 5º, XI), e só o dado anonimizado deixa de ser dado pessoal (art. 12).
Consequência prática: para quem detém o mapa, o corpus continua sendo dado pessoal sensível, com todas as obrigações. Por isso o isolamento físico importa tanto quanto a regex. O mapa em outra pasta, com outro controle de acesso, fora de qualquer sincronização de nuvem, é o que sustenta a afirmação “o modelo nunca viu o paciente”.
A referência internacional ajuda a calibrar o detector. O método Safe Harbor da HIPAA (45 CFR §164.514(b)(2)) lista 18 identificadores que precisam sair para um dado ser considerado desidentificado — nomes, datas ligadas à pessoa, telefones, e-mails, números de documento, endereços IP, fotos de rosto, entre outros. Nossa ferramenta de desidentificação cobre 17 dos 18, mais CPF, CNS e RG, que a lista americana não conhece, e roda inteira no navegador, sem enviar o texto para servidor algum.
Governança: quem responde pelo mapa e pelo prompt
O pipeline resolve a arquitetura. A governança resolve quem assina por ela.
Na CFM 2.454/2026, o uso de IA como apoio à decisão deve ser registrado no prontuário (art. 4º, V), e a instituição que desenvolve ou contrata IA precisa de governança interna nos termos do Anexo III — com auditoria, monitoramento e trilha de registros. Na LGPD, o fornecedor do modelo é operador; a clínica ou o serviço continua controlador e responde pelo que envia. O registro de operações de tratamento precisa dizer qual critério de anonimização foi aplicado e onde o mapa mora.
Cinco perguntas cobrem o essencial:
- Quais campos são úteis e quais são identificadores? Está escrito em algum lugar?
- A etapa de anonimização roda sem rede? Alguém consegue provar isso?
- Quem revisou a amostra antes da extração, e quantos documentos?
- Onde está o mapa de reidentificação, quem acessa, e ele está fora do diretório que a IA lê?
- O prontuário e o registro de tratamento dizem que um modelo participou, qual, e com que dado?
É a mesma lógica que aplicamos na documentação clínica assistida do anot.ae: a IA ajuda a escrever, mas o prontuário bruto não vira prompt de terceiro.
Se você está estruturando um projeto de extração ou classificação de documentos clínicos — na rede pública, numa clínica ou num produto — esse é o tipo de arquitetura que ajudamos a desenhar, do desenho dos campos ao registro de conformidade. Os documentos de base para a 2.454 estão no Kit CFM 2.454/2026, sem cadastro.
Fontes
- Planalto — Lei nº 13.709/2018 (LGPD), art. 5º, 11, 12 e 13
- Portal CFM — CFM normatiza uso da IA na medicina / Resolução CFM nº 2.454/2026 (texto integral), art. 4º, 6º, 16, 21, 23 e Anexos I e III
- ANPD — Consulta à sociedade sobre o Guia de Anonimização e Pseudonimização (2024)
- eCFR — 45 CFR §164.514(b): de-identification of protected health information
- HHS — Guidance Regarding Methods for De-identification of PHI
- anonimiz.ar — desidentificação de documentos clínicos no navegador